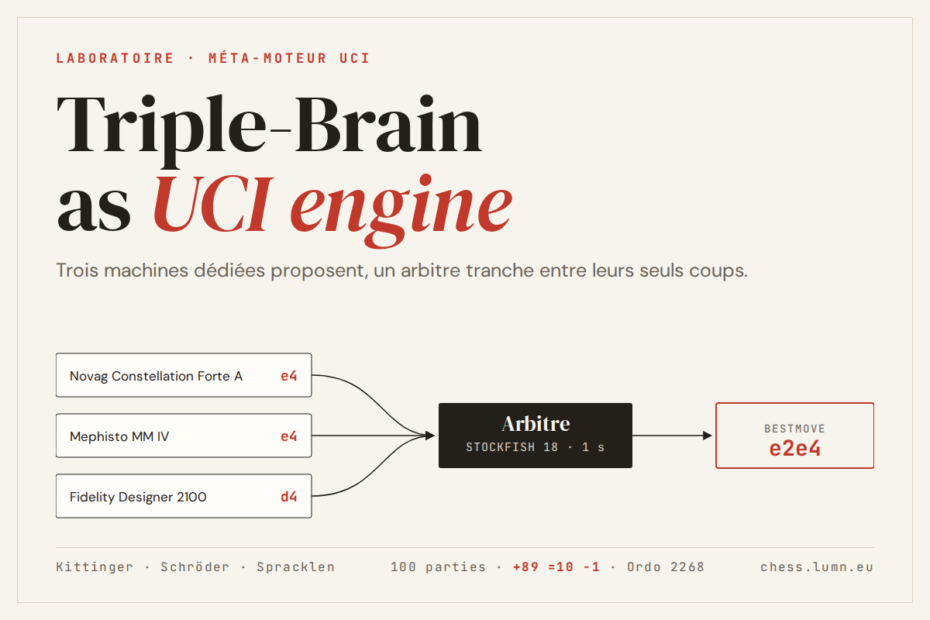
Laboratoire · méta-moteur
Trois cerveaux valent-ils mieux qu’un ?
Le Triple-Brain d’Ingo Althöfer : les statistiques qui manquaient en 1989.
Le Triple-Brain comme méta-moteur UCI, jouable sous toutes les interfaces.
Trois ordinateurs d’échecs des années 1980, un arbitre d’une seconde, et cinq cents points d’Elo qui sortent de nulle part — l’explication complète, pas à pas
On prend trois ordinateurs d’échecs de table, médiocres, écrits par trois personnes différentes : cotés 1775, 1790 et 1803. On les fait réfléchir sur la même position, en même temps, quinze secondes chacun. Chacun annonce un coup. Un arbitre choisit entre ces trois coups — entre ces trois-là et rien d’autre — et on joue celui qu’il a préféré. Sur cent parties contre ses propres membres, l’ensemble marque 94 points et n’en perd qu’une seule. Puis, contre vingt-huit machines qui ne sont pas les siennes, il confirme et fait mieux : Ordo le cote aujourd’hui 2315, contre 1803 pour le meilleur des trois.
Cette phrase ne devrait pas pouvoir être vraie, et c’est pour ça que cet article existe. Rien n’a été ajouté nulle part : pas une machine plus rapide, pas un programme plus récent, pas une seconde de réflexion supplémentaire. Les trois membres réfléchissent en même temps, pas l’un après l’autre, donc l’ensemble ne consomme pas plus de temps qu’un seul d’entre eux. Et l’arbitre ne joue pas aux échecs : on ne lui demande pas de trouver le meilleur coup de la position, seulement de dire lequel des trois coups proposés est le moins mauvais. C’est une tâche tellement plus facile qu’une seule seconde de calcul lui suffit.
Alors la force vient d’où ? D’un seul endroit, et c’est l’idée que tout le reste de l’article va mesurer : les trois programmes ne se trompent pas aux mêmes endroits. Chacun, tout seul, passe à côté du bon coup environ une fois sur deux. Mais là où l’un se fourvoie, un autre voit souvent juste — leurs points faibles ne sont pas les mêmes. Il suffit alors de quelqu’un pour remarquer lequel des trois a eu raison. Le gain ne vient pas de la puissance ; il vient de la différence.
Le trio est un vrai moteur d’échecs, au même titre que n’importe quel autre : il se présente, annonce ses réglages, et s’installe dans la liste des moteurs du logiciel Banksia comme on y installerait Stockfish. On peut donc le faire jouer contre ce qu’on veut — et surtout, on peut regarder les trois cerveaux se contredire en direct : à chaque coup, une ligne par machine avec ce qu’elle propose et ce qu’elle en pense, puis la décision de l’arbitre.
Cet article explique la construction d’un bout à l’autre : pourquoi trois auteurs et pas trois programmes, ce qu’on mesure exactement, comment on passe de cette mesure à une prévision de force, et pourquoi cette prévision s’est révélée très loin du compte — avec, en chemin, une petite leçon de statistique appliquée. À la fin, le résultat : 94 points sur 100, soit près de sept fois le gain que j’annonçais. Puis la contre-épreuve, contre vingt-huit adversaires extérieurs : 2315, cinq cent douze points au-dessus du meilleur membre.
1. L’idée, et à qui elle appartient
Elle est d’Ingo Althöfer, mathématicien à Iéna, qui l’a baptisée 3-Hirn — trois cerveaux. Dans sa version d’origine, à la fin des années 1980, deux programmes d’échecs proposent chacun un coup et un humain tranche. Althöfer a montré que le joueur ainsi assisté dépassait largement le meilleur des deux programmes, et il en a tiré toute une théorie des systèmes à choix multiple : un agent faible mais lucide sélectionne parmi les propositions d’agents forts mais aveugles.
La transposition d’ici change une seule chose, mais elle est essentielle : l’arbitre n’est pas un humain, c’est un programme bien plus fort que les membres. Stockfish 18 pèse quelque quinze cents points de plus que les machines qu’il arbitre.
Objection immédiate, et il faut y répondre tout de suite : si l’arbitre est si fort, pourquoi ne pas le laisser jouer seul ? Il gagnerait haut la main. C’est vrai, et c’est hors sujet. On ne cherche pas à construire la machine la plus forte possible. On cherche à savoir combien de force se cache déjà dans un groupe de programmes médiocres, et combien il en faut pour l’extraire. L’arbitre est un instrument de mesure, pas un joueur.
2. Pourquoi trois auteurs, et pas trois programmes
Voilà la contrainte qui structure tout le dispositif, et elle demande à être comprise avant le reste.
Un trio ne gagne pas parce que ses membres sont forts. Il gagne parce qu’ils ne se trompent pas ensemble.
Prenons l’exemple le plus simple. Trois programmes examinent une position où il existe un piège tactique. Si l’un des trois le voit, l’arbitre s’en apercevra — le coup qui évite le piège aura une bien meilleure note que les deux autres, et il sera joué. Le trio aura récupéré la clairvoyance d’un seul de ses membres. En revanche, si les trois tombent dans le piège, l’arbitre n’a rien à récupérer : il choisit le moins mauvais de trois mauvais coups, et le trio joue mal.
Tout dépend donc de la probabilité que les trois se trompent simultanément. Et c’est là que l’auteur entre en jeu : deux programmes écrits par la même personne partagent leur fonction d’évaluation, leurs extensions de recherche, leurs habitudes de programmation — et donc leurs angles morts. Un trio de programmes du même auteur ne vaudrait guère plus qu’un seul d’entre eux.
Trois auteurs différents — pour que les erreurs soient aussi peu corrélées que possible.
Écart de force ≤ 75 points d’Elo à l’intérieur du trio — un membre très inférieur ne propose jamais rien d’utile ; il ne décorrèle pas, il dilue.
Époques libres — un programme de 1987 et un de 2003 peuvent coexister. C’est même souhaitable : leurs angles morts n’ont aucune raison de coïncider.
Ces règles sont des hypothèses. Elles demandent donc à être testées, et c’est le point de méthode le plus important de tout le dispositif.
De vingt programmes on peut former 1140 triplets. La règle des 75 points en laisse 241, et celle des trois auteurs en retient 142.
Restent 99 trios où un auteur se répète — 89 où deux membres sur trois partagent un auteur, et 10 où les trois sont du même. Ceux-là ne servent pas à jouer. Ils servent de point de comparaison.
Si les 142 trios légitimes gagnent nettement plus que les 99 trios consanguins, ce sont bien des angles morts différents qui font le gain, et la règle des trois auteurs est fondée. S’ils gagnent autant, le gain ne vient pas de la diversité des auteurs mais de la simple multiplicité des propositions — et toute la thèse tombe.
Sans ce jeu témoin, le dispositif ne serait qu’une collection de chiffres flatteurs. C’est lui qui le rend réfutable.
3. Le vivier : vingt programmes, sept auteurs
Les candidats sont choisis dans une tranche de force étroite — de 1775 à 1968 points d’Elo — pour que la contrainte des 75 points laisse de quoi former des trios. Dix-sept machines dédiées émulées sous MAME, deux programmes DOS sous QEMU, et un portage.
| Auteur | Programmes | Lesquels |
|---|---|---|
| Richard Lang | 5 | Mephisto Amsterdam, Mondial 68000 XL, Roma 68000, Dallas 68000, Psion Chess 2.13 |
| Dave Kittinger | 4 | Novag Zircon II, Super Expert C, Super Forte C, Constellation Forte A |
| Julio Kaplan | 3 | Saitek Maestro D++, Corona II, Turbo King II |
| Ed Schröder | 3 | Mephisto Nigel Short, MM V, MM IV |
| Robert Hyatt | 2 | Cray Blitz 4.9h sur 486DX et sur ARM9 |
| Frans Morsch | 2 | Mephisto Modena, Saitek President |
| Dan & Kathe Spracklen | 1 | Fidelity Designer 2100 |
Deux précautions, qui illustrent le soin que demande ce genre de liste. Les deux Cray Blitz sont le même programme sur deux machines : ils servent de témoin pour vérifier que l’émulation MAME et l’émulation QEMU donnent le même jeu. Et Psion Chess est de Richard Lang comme les Mephisto 68000 — même auteur, donc jamais dans le même trio, même si les boîtiers n’ont rien à voir.
4. Ce qu’on mesure exactement : le centième de pion
Pour juger un coup, il faut une référence. Celle du laboratoire est Stockfish 18 — mille cinq cents points plus fort que les candidats, ce qui, à cette échelle, revient à une vérité de terrain.
Un programme d’échecs chiffre une position en unités de pion : +1,00 veut dire « l’avantage d’un pion », −3,00 « le désavantage d’une pièce mineure ». L’usage est de compter en centièmes de pion (en anglais centipawns), abrégés cp : +100 cp = un pion.
L’écart, en centièmes de pion, entre la note du coup joué et celle du meilleur coup de la position, telle que Stockfish 18 les évalue à la profondeur 18.
Un coup parfait a une perte de 0. Un coup qui laisse échapper un demi-pion a une perte de 50. Une bourde qui perd une tour aurait une perte de 500 — on plafonne d’ailleurs à cette valeur, parce qu’au-delà la distinction entre « très mauvais » et « catastrophique » n’apprend plus rien.
La perte moyenne d’un programme sur mille positions est l’indicateur central de tout cet article.
Les positions, justement : mille positions de milieu de partie, tirées des parties du laboratoire dans cette tranche de force. Coups 12 à 60, évaluation inférieure à trois pions en valeur absolue, une position par partie. Pas d’ouvertures, pas de positions déjà gagnées, pas de finales élémentaires — on ne garde que les positions où un coup se choisit vraiment.
5. La chaîne de mesure, étape par étape
Les vingt candidats jouent leur coup sur chacune des mille positions, en quinze secondes — la cadence des parties du laboratoire. Vingt mille coups.
C’est la seule étape lourde, et pour une raison physique. Pour les dix-sept machines dédiées, chaque position doit être posée sur un échiquier à capteurs, pièce après pièce, ce qui prend de dix à quatre-vingt-quinze secondes avant même que la réflexion ne commence. Une journée de machine.
Résultat : 19 993 coups. Il en manque sept, et c’est une histoire en soi — au paragraphe 11.
Stockfish 18 évalue chaque position à la profondeur 18, puis chaque coup proposé séparément. On en déduit la perte de chaque coup de chaque candidat. Dix minutes.
Pour chacun des 142 trios, on suppose un arbitre qui choisirait toujours la meilleure des trois propositions, et on calcule la perte moyenne de l’équipe. C’est un simple calcul — on prend le minimum des trois pertes, position par position — et c’est la borne supérieure de ce qu’un trio peut atteindre. Aucun arbitre réel ne fera mieux. Une minute.
Stockfish 18, un fil, une seconde, avec pour seule consigne de départager les coups effectivement proposés — en langage UCI, go movetime 1000 searchmoves e2e4 d2d4. Il ne cherche pas le meilleur coup de la position : il classe trois coups précis. Dix minutes.
6. Premier résultat : l’arbitre ne coûte presque rien
On dispose maintenant de deux arbitres comparables : l’oracle parfait de l’étape 3, qui est impossible à réaliser, et Stockfish à une seconde, qui l’est.
| Arbitre | Perte d’équipe | Erreurs |
|---|---|---|
| Oracle parfait (toujours la meilleure des trois) | 21,2 cp | — |
| Stockfish 18, 1 s, entre les coups proposés | 21,9 cp | 1 à 2 % |
| Un membre seul, en moyenne | 45 cp | — |
« Erreurs » : proportion des positions où les membres diffèrent et où l’arbitre n’a pas pris la meilleure proposition disponible, à dix centièmes de pion près.
Sept dixièmes de centième de pion séparent une seconde de Stockfish d’un oracle omniscient, soit quelque quatre points d’Elo.
Pourquoi une seconde suffit-elle, alors que les machines arbitrées, elles, réfléchissent quinze secondes ? Parce que les deux tâches n’ont rien de commun. Trouver le meilleur coup d’une position de milieu de partie, c’est explorer un arbre immense. Classer trois coups donnés, c’est comparer trois sous-arbres déjà identifiés. Le second problème est infiniment plus petit que le premier, et une seconde de Stockfish 18 — quelques dizaines de millions de positions — le règle.
L’arbitrage n’est pas le maillon faible. Si les trois membres portent la réponse, l’arbitre la trouve dans 98 à 99 % des cas.
Conséquence de méthode : toute l’incertitude du dispositif est ailleurs. Pas dans l’arbitre, pas dans l’oracle, pas dans les mille positions. Elle est dans la conversion d’une perte en centièmes de pion vers des points d’Elo — le paragraphe 9.
7. Ce que le trio gagne
Tout ce qui suit se compte sur les mille positions. Pas de pourcentages, pas de probabilités : des positions.
Le point de départ : un membre tout seul
Sur les mille positions, un membre du trio joue le coup quasi parfait — à moins de dix centièmes de pion du meilleur — dans 451 d’entre elles. C’est la moyenne mesurée sur les vingt candidats, et c’est le niveau à battre.
Ce que l’arbitre peut, et ce qu’il ne peut pas
Maintenant, trois membres proposent chacun un coup et l’arbitre prend le meilleur des trois. Mais il faut bien voir ce qu’il fait : il choisit, il n’invente pas. Si aucun des trois n’a trouvé le bon coup, l’arbitre ne le trouvera pas davantage — il n’a sous les yeux que trois propositions, et il prendra la moins mauvaise.
Toute la question se réduit donc à ceci :
Dans combien des mille positions le bon coup se trouve-t-il quelque part dans le trio ?
Réponse mesurée : 620 positions sur 1000.
Contre 451 pour un membre seul. C’est un vrai gain — mais est-il grand ou petit ? Pour le savoir il faut deux repères, et les voici.
Le plancher : trois exemplaires du même programme
Si les trois membres étaient des copies conformes, ils proposeraient toujours le même coup. Le trio trouverait le bon coup dans exactement 451 positions, comme un membre seul. Trois clones n’apportent rien du tout.
Ce plancher dit à quoi sert le trio : non pas à additionner de la force, mais à couvrir des trous différents.
Le plafond : trois membres aveugles à des endroits différents
À l’autre extrême, imaginons trois membres qui ne partagent aucun point faible. Chacun est aveugle, mais ailleurs que les deux autres. Suivons alors les positions une par une.
Voilà le plafond : 835 positions sur 1000. C’est le maximum qu’on pourrait espérer de trois programmes de cette force, à condition qu’ils ne se ressemblent en rien.
Entre les deux
Nombre de positions, sur mille, où le bon coup se trouve quelque part dans le trio. Le trio réel se place à mi-chemin entre ne rien gagner et tout gagner.
Le trio réel est à 620. Il gagne donc 169 positions sur les 384 qu’il aurait pu gagner — un peu moins de la moitié du bénéfice possible.
Et les 215 positions manquantes ont une cause unique, qui est le sujet de la section suivante.
Le trio ne peut jouer un bon coup que si au moins un de ses membres l’a trouvé. Dans 380 positions sur mille, aucun des trois ne l’a trouvé, et le trio y joue un coup médiocre quelle que soit la qualité de l’arbitre.
Le résultat d’ensemble, en centièmes de pion perdus par rapport au meilleur coup :
8. Les mêmes angles morts
Il manque donc 215 positions entre ce que le trio obtient et ce qu’il aurait obtenu si ses trois membres n’avaient aucun point faible commun. La raison tient en une phrase :
Les trois programmes sont aveugles aux mêmes endroits.
Quand l’un d’eux passe à côté du bon coup, les deux autres ont bien plus de chances de passer à côté aussi que si le hasard seul décidait. Les positions difficiles ne le sont pas pour un programme en particulier : elles le sont pour tous les trois à la fois.
La même chose vue sur les grosses bévues
On peut le vérifier autrement, et plus brutalement, en ne regardant que les grosses bévues — les coups qui perdent au moins un pion entier. Chaque programme du vivier en commet dans 152 positions sur 1000.
Prenons-les deux par deux. Si chacun se trompait dans son coin, les deux bévues tomberaient ensemble sur 152 × 152 / 1000, soit 23 positions. Comptons ce qui arrive vraiment :
Quatre-vingt-une positions au lieu de vingt-trois. Les deux programmes s’effondrent ensemble trois fois et demie plus souvent que si leurs points faibles n’avaient rien à voir. C’est la même chose que les 215 positions manquantes, vue à travers les seules grosses bévues.
Pourquoi c’était prévisible
Trois auteurs, trois décennies, trois architectures de processeur — et pourtant les mêmes trous. À la réflexion, rien de surprenant : tous ces programmes sont bâtis sur le même principe de recherche, avec des façons comparables d’élaguer les branches inutiles, et des évaluations qui comptent d’abord le matériel puis ajoutent des bonus de position. Une position qui tend un piège tactique à six demi-coups le tend aux trois pareillement.
Le concept de trio a un plafond, et ce plafond se mesure : 215 positions sur mille, c’est ce que les angles morts communs coûtent.
D’où la question que le jeu témoin doit trancher. Nos 142 trios réunissent trois auteurs différents. Les 99 trios témoins ont au moins deux membres d’un même auteur. Si ces derniers perdent nettement plus de 215 positions, alors la règle des trois auteurs est fondée : la diversité des auteurs est bien ce qui fait reculer les angles morts communs. Si l’écart est faible, c’est que le trio ne doit rien à la diversité et tout à la multiplicité — et la règle ne sert à rien.
9. Le passage délicat : des centièmes de pion aux points d’Elo
Tout ce qui précède se mesure en centièmes de pion. Mais la question qu’on veut poser — « le trio est-il plus fort que son meilleur membre, et de combien ? » — se pose en points d’Elo. Il faut donc un pont entre les deux, et c’est ici que les ennuis commencent.
Le pont le plus simple consiste à remarquer qu’on connaît à la fois la perte moyenne et l’Elo réel des vingt candidats. On peut donc chercher la relation entre les deux et l’appliquer ensuite au trio.
On place les vingt candidats sur un graphique : perte moyenne en abscisse, Elo en ordonnée. On cherche la droite qui passe « au mieux » au milieu du nuage — celle qui minimise la somme des carrés des écarts verticaux entre les points et elle.
Cette droite est un résumé du nuage. On peut ensuite lui demander : pour une perte de 21,9, quel Elo ? C’est exactement ce qu’on veut savoir du trio.
Appliquons-la. Voici l’ajustement brut sur les vingt candidats :
Elo = 2159 − 5,79 × perte · R² = 0,26 · σ = 57 Elo · n = 20
Le R² est la proportion de la variation des cotes que la droite explique. R² = 1 : tous les points sont exactement sur la droite. R² = 0 : la droite n’apprend rien de plus que la simple moyenne des cotes.
Le σ (écart type résiduel) est la dispersion typique des points autour de la droite, dans l’unité de l’ordonnée. Ici 57 points d’Elo : un candidat quelconque s’écarte en général de 57 points de ce que la droite prédit pour lui.
R² = 0,26, c’est-à-dire que le modèle explique un quart de ce qu’il faudrait expliquer. À ce stade, la tentation est de conclure que la perte moyenne ne prédit pas la force, et de passer à autre chose.
Ce serait une erreur. Parce que ce mauvais ajustement tient à un seul point.
Diagnostiquer avant de conclure
Quand un ajustement est mauvais, la bonne pratique n’est pas de regarder le R² mais de demander quels points le rendent mauvais. Deux outils standard répondent à cette question, et ils ne mesurent pas la même chose.
Le résidu est l’écart vertical d’un point à la droite : de combien le modèle se trompe sur ce point. C’est l’outil évident, et c’est le moins utile.
Le levier mesure à quel point un point est isolé en abscisse, loin du centre du nuage. Image : une planche en équilibre sur un pivot. Un poids placé au milieu ne la fait pas basculer ; le même poids placé tout au bout la retourne. Un point isolé à droite du nuage fait pivoter la droite d’ajustement exactement de cette façon — d’où le nom.
La distance de Cook combine les deux : elle mesure de combien la droite entière se déplacerait si l’on retirait ce point. C’est la question qui nous intéresse vraiment.
Pour vingt points et deux paramètres, les seuils d’alerte usuels sont de 0,20 pour l’un comme pour l’autre.
| Candidat | perte | levier | résidu | Cook |
|---|---|---|---|---|
| Saitek President | 66,8 | 0,650 | +105 | 9,05 |
| Fidelity Designer 2100 | 56,3 | 0,172 | −58 | 0,13 |
| Mephisto MM IV (v7.10) | 47,5 | 0,050 | −94 | 0,08 |
| Novag Zircon II | 40,7 | 0,129 | +44 | 0,05 |
| Mephisto Amsterdam | 43,8 | 0,074 | +61 | 0,05 |
Cinq premiers candidats sur vingt, classés par distance de Cook. Seuils d’alerte : 0,20 pour le levier comme pour Cook.
Le verdict est net. Le Saitek President a un levier de 0,65 pour un seuil à 0,20, et une distance de Cook de 9,05 pour un seuil à 0,20 — quarante-cinq fois le seuil. Remarquez que son résidu, +105, n’a rien d’extraordinaire : le MM IV en a un de −94 sans faire de dégâts. Ce n’est donc pas qu’il s’ajuste mal. C’est qu’il détermine la droite, parce que sa perte de 66,8 centièmes de pion le place à dix centièmes du suivant, seul tout à droite du nuage. C’est le poids au bout de la planche.
A-t-on le droit de le retirer ?
Oui, mais à une condition, et elle est stricte : la raison du retrait doit être indépendante du résidu. Retirer un point parce qu’il s’ajuste mal, c’est raisonner en rond — on améliore toujours un ajustement en supprimant ce qui le gêne. Il faut une raison extérieure à la mesure.
Ici, elle existe, et elle est antérieure. Le Saitek President est une anomalie documentée du laboratoire depuis le 19 octobre, avant même cette campagne : il résout 0 position sur 30 au test BT-2450 et 1 sur 30 au BT-2630, alors qu’il est coté 1877 en parties réelles. Aucun autre candidat ne présente un tel divorce entre les deux instruments — là où les autres machines de sa force en résolvent neuf à douze. Son évaluation fait manifestement quelque chose de particulier que ni la perte moyenne ni les tests de positions ne savent décrire.
Ce n’est pas un membre ordinaire de la population qu’on échantillonne. Le retirer n’est pas une commodité, c’est la bonne décision.
| Ajustement | R² | σ | Spearman | pente |
|---|---|---|---|---|
| les 20 candidats | 0,26 | 57 Elo | −0,80 | −5,79 |
| sans le President (n = 19) | 0,66 | 39 Elo | −0,88 | −15,13 |
| sans President ni Designer 2100 | 0,64 | 39 Elo | −0,86 | −18,14 |
Un seul point retiré fait passer la variance expliquée de 26 à 66 %. Retirer le suivant n’apporte plus rien, ce qui est la signature d’un outlier unique et non d’un nuage mal conditionné.
Le R² passe de 0,26 à 0,66, l’écart type résiduel de 57 à 39 points. Une remarque mérite d’être faite au passage : la colonne « Spearman » — la corrélation de rang, qui mesure si les candidats se classent dans le bon ordre sans se soucier de la forme de la relation — valait déjà 0,80 avec les vingt. Le classement était bon depuis le début. C’est l’ajustement linéaire qu’un seul point ruinait.
10. Et pourtant la meilleure droite donne une prédiction pire
Nous avons maintenant une régression honnête, diagnostiquée, avec un point écarté pour une raison antérieure à la mesure. Servons-nous-en.
| Ajustement | Elo prédit du trio | Gain sur le meilleur membre (1803) |
|---|---|---|
| sur 20 candidats (R² = 0,26) | 2032 | +229 |
| sur 19 candidats (R² = 0,66) | 2259 | +456 |
Les deux prédictions ne diffèrent pas d’une marge d’erreur : elles diffèrent d’un facteur deux sur la grandeur que l’on cherche à mesurer.
Améliorer l’ajustement a doublé la prédiction. C’est contre-intuitif et pourtant mécanique : la droite la mieux ajustée est aussi la plus pentue (−15,13 contre −5,79), et une droite plus pentue, extrapolée plus loin, donne un nombre plus grand.
Car c’est bien d’extrapolation qu’il s’agit, et voilà le vrai problème — pas le R².
Interpoler, c’est demander à un modèle une valeur située à l’intérieur du domaine où on l’a ajusté. C’est son usage normal.
Extrapoler, c’est lui demander une valeur en dehors. Le modèle répond toujours — une droite se prolonge indéfiniment — mais rien ne garantit que la relation qu’il résume continue de s’appliquer là-bas. Image : ajuster une droite sur un tronçon de route et lui demander où passe la route après le virage.
On demande donc au modèle de se prolonger sur une distance supérieure à celle qu’il a servi à décrire. Aucune régression ne survit à cela. Elle continuera de produire un nombre, et ce nombre dépendra bien plus de la pente — c’est-à-dire d’un ou deux points du nuage — que de la réalité.
Le test d’un prédicteur n’est pas son R², c’est sa robustesse. Une méthode dont la sortie double quand on retire un point sur vingt ne peut pas trancher une question — même si le point a été retiré à bon droit, et même si le retrait l’a rendue meilleure.
Ce dispositif de mesure est donc excellent pour classer les trios entre eux : la corrélation de rang est de 0,88, ils se rangent dans le bon ordre. Il est inutilisable pour prédire leur cote.
Et c’est exactement la distinction qu’on oublie quand on regarde un R² au lieu de regarder où se trouve le point qu’on veut prédire.
Deux remarques de même nature, pour finir ce chapitre.
Les douze meilleurs trios tiennent entre 21,2 et 21,5 centièmes de pion. Des écarts d’un dixième de centième sur mille positions, c’est du bruit. À l’intérieur du peloton de tête, le classement ne départage rien de réel.
Et le critère qu’on serait tenté d’employer est piégé. Classer les trios par « gain prédit sur le meilleur membre » revient à sélectionner les membres les plus faibles, puisqu’un membre faible laisse plus de marge au-dessus de lui. Les trios à +231 sont précisément ceux formés des trois candidats les plus faibles du vivier. Le bon critère n’est ni la force prédite ni le gain : c’est de réunir les trois membres dont les angles morts se recouvrent le moins, puisque c’est de là seulement que le gain provient. Cette analyse-là reste à faire.
11. Deux obstacles pratiques, dont un que j’avais cru réglé
La divergence
Pour faire jouer le trio, il faut en faire un moteur UCI — un programme que l’interface de tournoi interroge comme n’importe quel autre. Et là se tenait, depuis le lancement du projet, une objection qu’on croyait sérieuse.
Un membre propose X. L’arbitre lui préfère Y. Au coup suivant, que croit la machine ?
Si elle a joué X sur son propre échiquier, elle se trouve dans une position qui n’existe pas, et tout ce qu’elle proposera ensuite sera faux. Les solutions de repli envisagées étaient coûteuses : reposer la position complète à chaque coup — dix à quatre-vingt-quinze secondes chacun — ou ne garder que les machines capables de se corriger.
J’ai d’abord cru l’objection sans objet. En partie, l’interface de tournoi n’envoie pas une position : elle envoie la liste des coups depuis le début, et le module qui pilote la machine saisit ces coups sur l’échiquier à capteurs. Je me suis dit que la machine suivrait la liste, que le coup de l’arbitre lui arriverait comme un coup adverse, et que la divergence ne coûterait rien. J’ai même écrit que c’était réglé.
Le premier gauntlet a tranché en une après-midi : vingt-cinq parties perdues au temps sur trente-cinq, cinquante coups illégaux en deux parties, le décalage apparu dès le deuxième coup. En relisant non plus le relais mais le greffon de l’émulateur, la cause est apparue — et elle est à deux endroits.
Quand elle annonce son coup, elle le considère comme joué : il entre aussitôt dans sa propre liste. Et quand la liste de l’interface arrive, le greffon ne la compare à la sienne que par longueur, jamais par contenu. Si l’arbitre a joué un autre coup que le sien, les deux listes ont la même longueur, rien n’est saisi, et la machine réfléchit sur un échiquier faux jusqu’à la fin de la partie.
Elle ne sait pas qu’elle a été désavouée, et c’est précisément le problème.
Le remède est simple à énoncer. Un membre dont le coup a été retenu reste sur la liste incrémentale, comme avant. Un membre désavoué reçoit l’ordre de recommencer la partie à zéro, puis la liste complète des coups — que le greffon rejoue en mode édition, à vitesse d’émulateur débridé, c’est-à-dire en quelques secondes. L’échiquier est reconstruit depuis le départ, droits de roque et historique compris.
Restait à savoir ce que coûte ce rejeu. Mesuré sur les 2 323 rejeux du gauntlet : rien. Quatorze secondes en médiane par les deux chemins, dix-sept au pire contre quinze pour l’incrémental. Le rejeu tient dans la marge que la machine a de toute façon avant de commencer à réfléchir. Un membre sur trois est désavoué à chaque coup — ce qui colle au taux d’arbitrage — et ça ne se voit pas sur la pendule.
La position qu’on ne peut pas poser
L’autre obstacle est réel, celui-là, et il est instructif. Sur vingt mille coups demandés, il en manque sept. Sept candidats ont refusé la même position, et une seule : la n° 278.
r1b1k2r/ppp2ppp/2n5/4p3/2P1n3/2P1PN2/PB2BPPP/3RK2R b K -
Les sept y ont répondu e8g8 — le petit roque des Noirs — et le coup a été rejeté comme illégal. La raison tient dans le champ K de cette notation : il énumère les roques encore possibles, et il ne contient que le roque des Blancs du côté roi. Les Noirs n’ont plus aucun droit de roque : ils l’ont perdu plus tôt dans la partie en bougeant leur roi ou une tour, puis les pièces sont revenues sur leurs cases d’origine.
Une machine à échiquier physique ne peut pas savoir cela. On lui pose une position en plaçant des pièces ; le roi est en e8, les tours en a8 et h8, rien dans ce qu’elle voit ne dit que le roi a déjà voyagé. Elle roque, et elle a tort.
Cette classe de positions est inposable en principe sur une machine à capteurs, et aucun réglage n’y changera rien : un relais qui pose des pièces transmet un diagramme, pas un historique. Treize candidats sur vingt ont passé la position sans encombre — non pas parce qu’ils savaient, mais parce qu’ils ont préféré un autre coup.
Parmi les sept qui ont roqué figurent les quatre Mephisto 68000 de Richard Lang au complet : Amsterdam, Mondial 68000 XL, Roma 68000, Dallas 68000. Les trois autres relèvent de trois auteurs différents.
Une position ne prouve évidemment rien — avec sept machines sur vingt, voir les quatre Lang ensemble n’a rien d’extraordinaire par le seul hasard. Mais c’est exactement la forme qu’aurait une empreinte d’auteur si elle existe : les quatre programmes du même homme choisissent le même coup là où treize autres machines en préfèrent un autre. Reste à aller voir sur les neuf cent quatre-vingt-dix-neuf positions restantes.
12. Le méta-moteur, et les trois décisions qui comptent
Reste à écrire le programme qui parle UCI d’un côté et pilote trois machines plus un arbitre de l’autre. Trois décisions y déterminent si la mesure voudra dire quelque chose.
Les trois membres réfléchissent en parallèle
Chacun reçoit exactement les quinze secondes qu’il aurait seul, au même moment. Le trio ne s’octroie donc aucun temps de calcul supplémentaire : il paie seulement, sur sa propre pendule, la seconde de l’arbitre.
C’est la seule comparaison qui ait un sens. Un trio qui réfléchirait quarante-cinq secondes par coup — quinze pour chaque membre, l’un après l’autre — battrait évidemment son meilleur membre, et on n’aurait rien appris : on aurait mesuré ce que vaut le triple du temps, question déjà traitée ailleurs. Ici la question est : à pendule égale, trois cerveaux valent-ils mieux que le meilleur des trois ?
Un membre qui tombe ne fait pas tomber le trio
Les machines dédiées émulées ratent parfois la pose d’un coup. Un membre muet, mort, ou qui rend un coup illégal est donc simplement ignoré pour ce coup-là, et le trio joue avec les propositions restantes.
Mais trois échecs consécutifs et il est abandonné pour la partie — non par sévérité, par arithmétique. Un membre qui ne répond plus coûte son temps de réflexion plus sa marge d’attente à chaque coup, soit une minute et quart ; au bout de quelques coups le trio perdrait au temps. Mieux vaut finir la partie à deux membres que la perdre à la pendule.
Le compteur qui dit si la mesure est valide
Si les trois membres échouent sur un même coup, l’arbitre joue son propre meilleur coup. Il le faut bien : une partie ne s’interrompt pas. Mais ce coup-là n’est plus un coup de trio, c’est un coup de Stockfish, et il est compté comme tel sous le nom de secours.
Chaque partie produit donc son décompte : coups unanimes, coups arbitrés, secours, membres muets. C’est le premier chiffre à lire, avant même le score.
Une partie qui contient beaucoup de secours ne mesure plus un trio : elle mesure Stockfish. Le beau résultat qu’elle produirait serait un artefact — et sans ce compteur, on n’aurait aucun moyen de le savoir.
C’est le genre de garde-fou qu’on ne pense à installer qu’après s’être fait prendre une fois.
13. Ce que la littérature fait attendre
Il existe un précédent quantitatif, et il refroidit. Il ne vient pas des échecs mais du shogi — les échecs japonais : Obata, Sugiyama, Hoki et Ito, deux articles à la conférence Computers and Games de 2010. Ils font voter plusieurs instances d’un même programme, décorrélées par des graines aléatoires différentes. Deux résultats.
Le premier est une leçon de conception. La règle optimiste — prendre le coup du joueur dont l’évaluation est la plus haute — bat le vote majoritaire. Compter les voix est moins bon qu’écouter le plus confiant. C’est contre-intuitif, et ça se comprend : le programme qui annonce la meilleure évaluation est souvent celui qui a vu quelque chose que les autres n’ont pas vu, et la majorité l’écraserait.
Le second est un ordre de grandeur, et c’est celui qui compte ici : le gain demande seize joueurs ou plus pour faire passer le taux de victoire de 50 à 60 %. Soit seize instances pour environ soixante-dix points d’Elo.
Nous en avons trois. Trois auteurs différents écartent certainement mieux les angles morts communs que trois graines aléatoires — c’est tout l’argument du dispositif — mais sûrement pas au point de remplacer treize joueurs.
L’estimation initiale de ce projet — entre 130 et 180 points de gain pour trois membres — est selon toute vraisemblance deux fois trop haute. Prévision révisée : +40, peut-être +70.
Et cet argument-là ne doit rien à la régression du paragraphe 9 : il vient d’une mesure indépendante, sur un autre jeu, par d’autres gens. Quand deux raisonnements sans rapport pointent dans la même direction, il faut les écouter.
Une bonne nouvelle pour finir sur ce point : notre conception est au-dessus des deux règles japonaises. Ni vote majoritaire, ni règle optimiste, mais un juge externe plus fort que tous les membres. C’est une troisième règle, plausiblement la borne supérieure de la famille — et les 1 à 2 % d’erreur mesurés au paragraphe 6 disent qu’elle est presque gratuite. Si les trois membres portent la réponse, l’arbitre la trouve.
14. Le résultat
L’expérience était celle-ci : faire jouer le trio contre chacun de ses trois propres membres, même livre d’ouvertures des deux côtés, même cadence, et regarder le score. Le trio retenu, baptisé depuis Orion, réunit Novag Constellation Forte A (Kittinger, 1803), Mephisto MM IV v7.10 (Schröder, 1790) et Fidelity Designer 2100 (Spracklen, 1775).
Cent parties, jouées du 23 octobre 2026 à 17h19 au 24 octobre à 4h19. Voici le résultat complet.
| Adversaire | Elo | Score du trio | V / N / D |
|---|---|---|---|
| Novag Constellation Forte A | 1803 | 31,0 / 34 | 29 / 4 / 1 |
| Mephisto MM IV (v7.10) | 1790 | 32,0 / 33 | 31 / 2 / 0 |
| Fidelity Designer 2100 | 1775 | 31,0 / 33 | 29 / 4 / 0 |
| Total | 1790 | 94,0 / 100 | 89 / 10 / 1 |
Quatre-vingt-neuf victoires, dix nulles, une défaite — 94,0 % des points. Cote calculée par Ordo contre des adversaires à cote fixe : 2268 ± 73, soit 465 points de plus que son meilleur membre.
Les parties sont-elles valides ?
C’est la première chose à vérifier, et c’est pour ça que le méta-moteur tient un journal de chaque partie. Sur les cinquante-trois journaux relus, soit 2 353 coups :
- zéro coup illégal — aucun membre n’a perdu le fil de la partie ;
- zéro secours — pas une seule fois l’arbitre n’a dû jouer son propre coup faute de proposition valide. Chaque coup joué est bien un coup de trio ;
- zéro membre muet — les trois machines ont répondu à chaque fois ;
- accord unanime dans 36,4 % des coups, à comparer aux 34 % mesurés sur les mille positions de test. Sur 2 353 coups l’écart est négligeable : les positions de test ressemblent donc bien aux positions de partie, ce qui n’allait pas de soi.
Huit parties ont tout de même été écartées en cours de route, et il faut dire lesquelles. Six sont des défaites au temps datant d’avant la correction de cadence — le trio jouait alors avec la pendule de son adversaire, deux fois trop courte pour lui. Les deux autres sont des pannes du côté adverse : un coup illégal de MM IV et une connexion bloquée de Forte A, tous deux jouant comme adversaires simples. Après une heure du matin, plus aucun incident.
Quant à l’unique défaite, elle est propre : une Semi-Slave perdue contre Forte A le 24 octobre à 1h58, matée en 82 coups, sans le moindre incident technique — le trio était à moins quatorze dès le coup 79. Il a été battu, voilà tout. Et c’est précieux : tant qu’un score reste parfait, la cote n’est plus adossée à rien.
Et la prédiction ?
Rappelons les trois hypothèses, telles qu’elles étaient écrites avant la première partie.
| Hypothèse | Gain prédit | Score attendu |
|---|---|---|
| Littérature sur le shogi — la prédiction de cet article | +40 à +70 | 56 à 60 % |
| Régression sur 20 candidats | +229 | 79 % |
| Régression sur 19, qualifiée ici d’extrapolation intenable | +456 | 94 % |
| Mesuré | +465 | 94,0 % |
Cet article annonçait 56 %. La prédiction était fausse, et de très loin. Et le plus savoureux est ailleurs : l’extrapolation que j’avais déclarée intenable annonçait +456. Le résultat mesuré est +465. Neuf points d’écart, très largement à l’intérieur de la marge d’erreur.
Dans le transport d’un chiffre sans ses conditions. Les Japonais obtenaient leur gain en faisant voter des instances d’un même programme, décorrélées par des graines aléatoires différentes — c’est-à-dire la plus faible diversité qu’on puisse fabriquer : même évaluation, même recherche, mêmes angles morts, seul le hasard des départages change. Il leur fallait seize joueurs pour en tirer quelque chose, et c’est logique.
Trois programmes de trois auteurs, trois décennies et trois architectures, ce n’est pas le même objet. J’ai pris leur nombre sans prendre leur régime.
Ce qui reste juste, en revanche, c’est l’argument sur la robustesse : une méthode dont la sortie double quand on retire un point sur vingt n’est pas fiable. Mais pas fiable ne veut pas dire fausse, et j’avais confondu les deux.
Ce que ce chiffre ne dit pas
Quatre-vingt-quatorze points sur cent, c’est le plafond de l’instrument. À ce niveau, la cote n’est plus déterminée par les parties mais par le modèle qui les interprète, et l’intervalle de ±73 est optimiste : il suppose que les trois adversaires sont cotés sans la moindre erreur, ce qui est faux.
On l’a d’ailleurs vu glisser sous nos yeux. Après 27 parties le trio était à 96,3 %, après 45 à 95,6 %, après 77 à 93,5 %, et il finit à 94,0 %. Ce n’est pas qu’il ait faibli : c’est qu’un petit échantillon flatteur se régularise. La leçon est générale et vaut d’être retenue — plus un score est proche de 100 %, moins la cote qu’on en tire est solide, et c’est précisément quand le résultat est spectaculaire qu’il faut attendre la fin.
C’est très exactement la saturation de plateau dont il est question dans l’autre article de ce laboratoire — sauf qu’elle frappe ici le trio lui-même. Le trio a dépassé ses propres membres en tant qu’instrument de mesure. Ses adversaires valent 1790 ; lui vaut 2268.
Alors la question initiale est tranchée, et nettement : oui, trois cerveaux valent mieux qu’un, et bien plus que ce que la littérature laissait attendre. Mais la question suivante — combien exactement — demandait d’autres adversaires. Ils sont venus : c’est le paragraphe 15.
Reste enfin la question que ce dispositif a été construit pour poser, et qui n’est toujours pas tranchée : ce gain vient-il de la diversité des auteurs ou de la simple multiplicité des propositions ? Les 99 trios témoins, où un auteur se répète, attendent leur tour. Tant qu’ils n’auront pas joué, on saura que le trio gagne, sans savoir pourquoi.
15. La contre-épreuve : cent dix parties contre des inconnus
La réserve du paragraphe précédent était la bonne : contre ses propres membres, le trio jouait contre ses propres angles morts. Il fallait le confronter à des machines qui ne lui doivent rien. Le trio a d’ailleurs reçu un nom entre-temps : Orion.
Du 26 au 28 octobre, Orion a affronté vingt-huit programmes cotés de 2080 à 2350, dont aucun n’est l’un de ses membres : les machines dédiées de Lang, Kittinger, Spracklen et Schröder, les programmes DOS de Morsch, Hirsch, Lang et Schröder sur 486 et Pentium émulés, les cartes ChessMachine de Schröder et de Koning, Fruit et Crafty sur ARM9, Psion sur un 286 à 1800 MHz. Quatre parties contre chacun, deux de chaque couleur (deux seulement contre le Star Diamond), même livre et même cadence que le 23 octobre.
| Adversaires | Moyenne | Parties | Score d’Orion | Performance |
|---|---|---|---|---|
| 2050 à 2150 | 2101 | 24 | 19,0 (79 %) | 2333 |
| 2150 à 2250 | 2196 | 46 | 33,5 (73 %) | 2367 |
| 2250 à 2350 | 2304 | 40 | 18,5 (46 %) | 2278 |
| Total | 2214 | 110 | 71,0 (64,5 %) | 2319 |
Cinquante-neuf victoires, vingt-quatre nulles, vingt-sept défaites. Performance calculée sur la cote moyenne des adversaires ; le gauntlet lui-même, à adversaires de cote fixe, donne 2324 ± 35.
Le chiffre qui compte vient ensuite. Ordo, qui reprend désormais les 210 parties d’Orion avec toute la liste du laboratoire, le cote 2315.
Contre des adversaires qui ne partagent pas ses angles morts, Orion ne s’est pas effondré : il est monté. La première estimation était bridée par le plafond de l’instrument, à 94 % on ne mesure presque plus rien. Face à des machines de sa force, la mesure respire, et elle donne quarante-sept points de plus. Trois ordinateurs de table de 1986 à 1988, quinze secondes chacun, et le résultat se classe au-dessus de Fritz 3 et de MChess Pro 6 sur le 486 de l’époque.
Le gain tient face à l’inconnu. C’était la question laissée ouverte le 24 octobre, et elle est tranchée : Orion bat 4 à 0 MChess 1.71, Fritz 2 et Fritz 1 sur 486, et Crafty sur ARM9, et marque au moins la moitié des points contre vingt-trois de ses vingt-huit adversaires.
Il fléchit là où la thèse le prévoit. Dans le tiers le plus fort, il ne marque que 46 % (1 sur 4 contre Fruit 2.1 sur ARM9, coté 2350). Des adversaires plus forts trouvent plus souvent ce qu’aucun des trois membres n’a vu. Même là, sa performance de 2278 reste à près de cinq cents points de son meilleur membre.
Les parties sont propres. Vingt journaux relus, 1 444 coups : zéro secours, un seul membre muet (dans une finale déjà jouée), accord unanime dans 34,4 % des coups, contre 34 % sur les positions de test et 36,4 % le 23 octobre.
Une partie : Orion – Saitek Sparc, 28 octobre 2026
Parmi les parties dont le journal a été conservé, une montre mieux que les autres ce que fait le trio. Le Saitek Sparc, programme des Spracklen coté 2176, défend une Sicilienne Najdorf contre l’attaque 7.f4. Sur 89 coups d’Orion après le livre, 38 sont unanimes et 51 arbitrés. Trente-quatre fois, le coup joué n’avait été proposé que par un seul membre : quatorze fois le MM IV, douze fois le Forte A, huit fois le Designer. Et l’arbitre a écarté dix-huit gaffes de membres, des coups qui perdaient au moins un pion et demi.
L’évaluation au fil de la partie
Évaluation Stockfish 16, du point de vue d’Orion, bornée à ±6 pions. Les points marquent les moments commentés ; un clic place la partie à ce coup.
Les moments clés
Chaque diagramme montre la position avant le coup. Flèches : la proposition de chaque membre dans sa couleur, le coup joué en vert, et en pointillé le coup de Stockfish quand aucun membre ne l’a proposé.
Rejouer la partie
Flèches ← → du clavier pour avancer et reculer.
Et maintenant, sept cerveaux
Si trois auteurs valent cinq cents points, que valent sept ? Le méta-moteur accepte désormais de deux à huit membres, et l’heptade a un nom : Pléiades. MChess 1.71 (Hirsch), RISC 2500 (de Koning), Fritz 2 (Morsch), Elite Avantgarde V9 (Spracklen), Gideon 3.1 sur ChessMachine (Schröder), Mephisto Berlin 68000 (Lang) et Novag Sapphire (Kittinger) : sept auteurs, cotés en moyenne 2149.
Son premier gauntlet a commencé le 29 octobre au matin, contre dix programmes cotés en moyenne 2360, Rebel 9, Fritz 3 et Stockfish 11 sur 68020 compris. Après une partie contre chacun : 9 sur 10. L’unique défaite est une finale de cavaliers égale, perdue sur un coup qu’aucun des sept n’a proposé. Dix parties ne font pas une cote, et ce chiffre bougera. Mais la direction est donnée, et le gauntlet suivant visera cinq cents points au-dessus de ses membres.
Reste la question de fond, toujours ouverte : diversité des auteurs, ou simple multiplicité des propositions ? Les 99 trios témoins n’ont toujours pas joué. Mais une chose est acquise : l’idée marche, au-delà de tout ce que la littérature laissait attendre, et elle marche contre n’importe qui.
Sources
- I. Althöfer, Improved game play by multiple computer hints, Theoretical Computer Science, 2003 — le 3-Hirn et les systèmes à choix multiple
- T. Obata, T. Sugiyama, K. Hoki & T. Ito, Consultation Algorithm for Computer Shogi: Move Decisions by Majority, CG 2010
- T. Sugiyama, T. Obata, K. Hoki & T. Ito, Optimistic Selection Rule Better Than Majority Voting System, CG 2010 — seize joueurs pour passer de 50 à 60 %
- K. Regan & G. Haworth, Intrinsic Chess Ratings — la pondération par difficulté de position, remède connu à la platitude de la perte moyenne
- Engine Similarity — SIM03 de Don Dailey, et l’usage forensique de l’accord sur les coups
- Mesures du laboratoire : resultats\trio\candidats_bilan.tsv et trios.tsv du 23 octobre 2026 ; cotes de la liste Performance Elo du 22 octobre 2026, calculée par Ordo.
- Gauntlet d’Orion contre vingt-huit adversaires cotés 2050-2350, 26-28 octobre 2026, et liste Ordo du 29 octobre 2026 ; journaux d’Orion (coups et évaluations des membres) ; premier tour du gauntlet de Pléiades, 29 octobre 2026.
chess.lumn.eu · laboratoire de calibration · 24 octobre 2026 · mis à jour le 29 octobre 2026